TL;DR:full-duplex spoken model 的主问题已经从「能不能同时听和说」推进到「能不能在连续语音流里做正确的 floor-control decision」。Moshi 先把实时双流 speech-to-speech 建起来,Full-Duplex-Bench 把 pause handling、turn-taking、backchanneling、interruption management 变成可测指标,后续 alignment/RL 工作开始把 interaction timing 从语义生成里拆出来优化。DuplexPO(arXiv:2607.07148)的关键处理是:只在 dynamics-critical windows 里采样,用 FCDR 分解 start/backchannel/stop/regularization reward,再用 GRPO-style objective 更新局部 policy,同时通过 KL 和 SFT reference 保住 what to say。
full-duplex RL 的脉络要先从一个更朴素的问题开始:语音模型已经会回答问题以后,为什么还要专门学「什么时候说」?
传统 voice assistant 像一个严格排队的柜台:用户说完一句,系统转写一句,LLM 生成一句,TTS 再读一句。这个流程在任务型 QA 里很自然,因为它默认对话已经被切成整齐的 turn。真实对话更像两个人共用同一个声道:用户会停顿、补充、犹豫、打断;听者会用很短的 backchannel 表示还在听;说话权的交接经常发生在几百毫秒的窗口里。
所以 full-duplex spoken model 最后面对的对象不只是文本 token。它每一小段时间都在回答三个问题:
content: 现在要说什么
timing: 现在该不该开口
state: 如果用户开始说话,系统该继续、停下,还是只给短反馈
这三个问题混在一起训练,就容易出现一个熟悉现象:模型答案没错,但交互很别扭。它可能在用户长停顿时抢话,也可能在用户真正说完以后沉默太久,还可能把本该一声「嗯」的 backchannel 变成完整句子。
本文目录如下:
0. 什么是 full-duplex spoken model?
1. 第一阶段:先把双流实时建起来
2. 第二阶段:把自然交互拆成可测行为
3. 第三阶段:为什么 SFT 到这里会变弱
4. 第四阶段:RL 怎么进入 full-duplex
5. DuplexPO:把 conversational dynamics 单独拿出来优化
6. 实验结果说明了什么
7. 对 RL infra 的启发
8. 结语
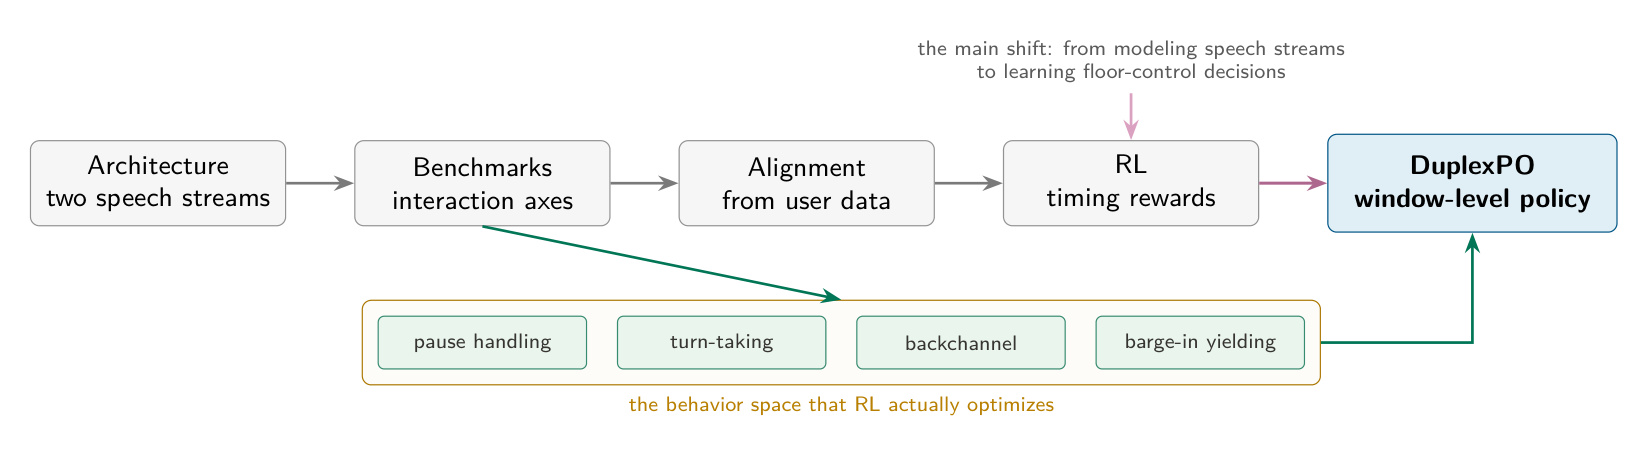
full-duplex spoken model RL 的主线:先获得双流实时能力,再把互动行为拆成评估维度,最后用局部 RL 优化 floor-control decisions。
0. 什么是 full-duplex spoken model?
half-duplex 的系统只有一个隐含规则:同一时间只有一方说话。系统通常等用户输入结束,再开始生成。这种规则把复杂对话简化成下面的流水线:
user speech -> ASR -> text LLM -> TTS -> agent speech
full-duplex 取消了这个假设。用户语音流 x1:T 一直进来,agent 输出流 y1:T 也可以同时产生。每个时刻,模型既要听用户当前在说什么,又要决定自己当前的发声状态:
for each frame t:
    observe user stream x_<=t
    observe agent history y_<t
    decide y_t in {silence, speak, backchannel, yield, ...}
Moshi(arXiv:2410.00037)是这条线很重要的起点。它指出传统 pipeline 会累积数秒级 latency,文本中间表示会丢失 emotion 和 non-speech sound,turn-based segmentation 也处理不好 overlap、interruption、interjection。Moshi 还引用了一个经验事实:overlapping speech 约占 spoken time 的 10% 到 20%。
Moshi 的做法是把 spoken dialogue 建成 speech-to-speech generation。模型同时处理 user stream 和 agent stream,用 text token 作为 audio token 的前缀来稳住语言质量。论文报告 theoretical latency 为 160ms,实践中约 200ms。
这一阶段解决的是「模型形态」问题:模型终于可以在结构上同时听和说。但结构准备好以后,新的问题马上出现:模型有没有学会在共享声道里守规矩?
1. 第一阶段:先把双流实时建起来
Moshi 之后的一批工作主要在回答「full-duplex 模型该怎么搭」。
Freeze-Omni(arXiv:2411.00774)强调 frozen LLM backbone,把 speech encoder/decoder 接到文本 LLM 上,避免有限语音数据把原有语言能力冲淡。论文摘要报告它用 8 张 GPU 和 60,000 条 multi-round text QA data 训练 speech-to-speech conversation 能力。
SALM-Duplex(arXiv:2505.15670)进一步把 continuous user inputs 和 codec agent outputs 放在一个模型里处理。论文报告 barge-in success rate 从 Moshi 的 55.1% 到 94.5%,barge-in latency 为 0.69s。
SALMONN-omni(arXiv:2505.17060)走 codec-free 路线,强调 standalone speech LLM 自己管理 speaking/listening state。论文报告在 predicted turn-taking setting 下,相比已有开源 full-duplex speech interaction LLM 平均提升 35.9%。
把这些放在一起看,第一阶段的核心可以概括成三件事:
1. 降低端到端语音交互 latency
2. 让 user stream 和 agent stream 可以重叠存在
3. 尽量保住原本 LLM 的语言和推理能力
但 full-duplex 的难点没有被 architecture 完全消化。一个系统能在用户说话时输出音频,和它知道什么时候该输出音频,是两个不同问题。后者需要评估和优化 floor-control 行为。
2. 第二阶段:把自然交互拆成可测行为
Full-Duplex-Bench(arXiv:2503.04721)把问题往前推了一步。它跳出只测 QA、ASR 或普通 speech quality 的框架,把 full-duplex interaction 拆成四个维度:
- pause handling:用户只是中间停顿时,模型保持安静;
- backchanneling:用户连续说话时,模型给短反馈,但不接管话题;
- smooth turn-taking:用户真的让出 floor 时,模型及时接话;
- interruption management:用户打断时,模型能停下并切换关注点。
这四个维度很关键。以前说一个 voice agent「自然」或者「不自然」,常常很难定位原因;Full-Duplex-Bench 把自然交互拆成了可测的局部行为。模型失败以后,可以问得更具体:
它是在 pause 上过早开口?
还是在 turn-taking 上反应太慢?
还是 backchannel 太长,变成了抢话?
还是用户打断后没有 yield?
这个 benchmark 也把 full-duplex RL 的方向暗示出来了。SFT 可以模仿一段对话的 token 序列,但很多失败发生在极窄的时间窗口。一个 <BOS> 提前几帧,一个 <EOS> 晚几帧,文本内容可能完全合理,交互体验已经变了。
所以 full-duplex 的优化目标逐渐从「整段回复好不好」变成「某个互动事件附近的决策对不对」。
3. 第三阶段:为什么 SFT 到这里会变弱
SFT 在 full-duplex 里会遇到两个问题。
第一个问题是 credit assignment。自然语音对话很长,真正决定体验的动作经常只在边界附近出现。比如用户说完一个 clause 后停了 400ms,模型开口是否合适,取决于前后语义、prosody、停顿长度、历史节奏。把整段音频都丢给 token-level likelihood,训练信号会被大量无关 token 稀释。
第二个问题是目标混合。自然对话数据里有许多 fragment、overlap、短反馈和修补语。完整模仿它,可能学到交互节奏,也可能让 assistant-style instruction following 变弱。DuplexPO 把这个现象称为 intelligence-dynamics trade-off:full-duplex dynamics 越强,reasoning 和 instruction-following 可能越弱。
直观地说,SFT 同时在教两件事:
what to say: 语义内容、推理、指令遵循
when to speak: 开口、停顿、让出、短反馈
这两个目标共享同一段训练序列,但需要的监督粒度不同。what to say 常常需要长上下文和语义判断;when to speak 常常发生在几百毫秒的局部窗口里。继续把它们放在同一个 token likelihood 里优化,信号会互相干扰。
后面的 RL 工作基本都围绕同一个问题展开:怎样单独优化 interaction timing,同时尽量不动语义能力?
4. 第四阶段:RL 怎么进入 full-duplex
full-duplex RL 的问题一直在变:一开始大家想把真实用户互动变成 preference signal;很快发现 preference 太粗,需要 reward;reward 做出来以后,又发现 timing reward 会伤语义;再往后,优化对象开始从整段对话收缩到短 segment、短 window。
我把这条路线拆成五个 stage。
4.1 Stage 1:从真实用户互动里构造 preference
Aligning Spoken Dialogue Models from User Interactions(arXiv:2506.21463)解决的是一个很基础的问题:text RLHF 的 preference data 不能原样搬到 speech dialogue。
文本 preference 通常长这样:
context = text_prompt
winner = better_text_answer
loser = worse_text_answer
full-duplex speech conversation 复杂很多。它没有干净的 turn boundary;用户和模型可以同时说话;错误也不只来自内容,还可能来自 interruption、prolonged silence、overlap、backchannel timing。论文的处理流程大概是:
raw_live_conversations
    -> timestamped ASR transcript
    -> LLM judge marks problematic replies
    -> split issues into content-related and timing-related
    -> synthesize preferred response with matched timing
    -> train with DPO-LN on the model text stream
这里有几个细节很重要。
-
preference 来源是真实互动:作者部署 Moshi,让用户自由对话,再从 raw multi-turn speech conversations 里构造 preference pairs。unique-context 数据集包含 154,301 pairs,其中 timing-only issues 占 57%,content-only issues 占 20%,两者都有占 23%。
-
timing issue 被显式标出来:论文把 interruption 和 unresponsiveness 放进 LLM judge 的评估轴。timing-only 数据里,18% 来自 model cutting the user,82% 来自 model not answering within appropriate time。
-
DPO 只算 text stream 概率:论文尝试过同时用 text token 和 audio token 的概率估计,但训练不稳定、效果差;最后使用 text-token-only 的 DPO-LN。
这个 stage 的价值是把真实用户反馈接进 full-duplex model alignment。它留下的问题也很明显:preference pair 仍然是离线、相对粗粒度的信号。一个 pair 可以告诉模型「这段回复更好」,但很难精确指出「第 37 帧该停,第 49 帧该重新开口」。
4.2 Stage 2:从 preference 走向 interaction reward
下一步自然是 reward modeling。full-duplex 需要在线或准在线的 scalar reward,才能支撑 rollout-based RL。
ORISE 这条线把 full-duplex SDLM 的互动行为放进 online RL。DuplexPO 的 related work 对它的评价很明确:ORISE 的 rollout-level reward 能改善 spoken interaction,但 sequence-level assignment 仍然偏粗,很难把成功或失败归因到具体实时决策。
Dual-Axis Generative Reward Model(arXiv:2604.14920)进一步把 reward 本身变成研究对象。它指出当时常见自动指标有几个问题:behavioral statistics 只数表面事件,timing-prediction proxy 对内容不敏感,metrics suite 虽然细但高延迟且难以融合成 RL 所需的统一 reward;普通 LLM-as-a-judge 又主要面向 turn-based dialogue,容易误判 full-duplex 里的 simultaneous speaking/listening。
Dual-Axis 的回答是训练一个 interaction-aware generative reward model,同时给出 semantic quality 和 interaction timing 两个轴的评价。它的核心抽象可以写成:
dual_track_dialogue
    -> interaction taxonomy
    -> reward_model(dialogue)
    -> {
        "semantic_quality": score_sem,
        "interaction_timing": score_time,
        "overall_reward": score_all,
    }
这个 stage 解决的是 reward 可用性问题:从 pairwise preference 走向可诊断、可打分的 interaction reward。它留下的问题是 credit assignment。reward model 可以说一段 interaction timing 不好,但 full-duplex policy 需要知道具体哪一小段时间该改。
4.3 Stage 3:timing reward 会把 raw-token policy 带偏
ASPIRin(arXiv:2604.10065)抓住了一个更具体的问题:用标准 GRPO 直接优化 raw token policy,会让模型为了 timing reward 牺牲 semantic coherence。
论文的实验里,Standard GRPO 会让模型变得更积极:turn-taking 和 user interruption 的指标改善,latency 下降;但 pause handling 和 backchanneling 变差,模型更容易持续说话,也会导致 semantic coherence 下降。摘要里还提到,ASPIRin 相比 standard GRPO 把 duplicate n-grams 的比例降低超过 50%,用来说明 raw-token timing RL 带来的 repetition/generative collapse 被缓解。
ASPIRin 的处理方式是 Action Space Projection。它避免让 timing reward 直接作用在完整 vocabulary 上,先把 token 分成两类:
V_pad      -> inactive_silence
V_non_pad  -> active_speech
然后在 projected binary state policy 上做 GRPO:
for token_step in generation:
    raw_logits = model(...)
    state_logits = {
        "inactive": sum_logits(V_pad),
        "active": sum_logits(V_non_pad),
    }
    optimize state_policy(active_or_inactive) with timing reward
这个 stage 的贡献是把 action space 和 reward 对齐。timing reward 本来只关心 active/inactive、interrupt/latency,却被 raw-token RL 强行分摊到每个具体词上;ASPIRin 把优化对象收窄到 state policy,语义 token selection 受到的干扰小很多。
但 ASPIRin 也留下一个限制:binary state 能处理「说/不说」的大方向,对 backchannel 类型、turn initiation 精度、barge-in 后的停止模式,表达能力仍然偏粗。下一步就会自然走向 axis-specific reward。
4.4 Stage 4:把 interactivity 拆成多个轴分别优化
Multi-Faceted Interactivity Alignment(arXiv:2606.11167)接着处理 reward 覆盖范围的问题。它指出,已有 RL 方法通常只覆盖一部分互动行为,比如 barge-in 或 backchannel;full-duplex interactivity 至少要覆盖四个 canonical axes:pause handling、turn-taking、backchanneling、user interruption。
它的训练流程是:
for each RL step:
    axis = sample({pause, turn, backchannel, interruption})
    segment = sample(D_axis)
    completions = policy.sample(segment, G)
    rewards = R_axis(completions)
    advantages = normalize(rewards within group)
    update with GRPO + KL(reference_policy)
每个 axis 都有独立 reward:
- pause handling:用户还在自己的 utterance 内停顿,模型应该保持安静;生成超过 1s 的 speech interval 会被惩罚。
- turn-taking:用户让出 floor 后,模型越快开始合适回复越好;reward 用 response delay 的负值。
- backchanneling:模型应该在参考 backchannel 位置附近给短反馈,同时避免 takeover;reward 用 backchannel F1。
- user interruption:用户打断后,模型需要识别 interruption 并及时回应;reward 也按 delay 设计。
它还加了 LLM Judge reward 来保护 response quality,尤其用于 turn-taking 和 user-interruption 轴,避免只优化 delay reward 带来的 semantic degradation。
这个 stage 的重要性在于,它把 Full-Duplex-Bench 的评估轴反过来用作训练轴。评估不再只是 leaderboard,开始变成 reward design 的结构。
4.5 Stage 5:从 short segment 继续收缩到 dynamics-critical window
到 Multi-Faceted 这里,RL 已经有了四轴 reward,也已经用短 audio segment 替代整段对话。但 DuplexPO 还要再往前收一步:full-duplex 的错误往往发生在 event boundary 附近,训练应该集中到 dynamics-critical windows。
DuplexPO 对前面几条路线的取舍可以这样概括:
User Interactions:
    live interaction -> preference pairs

Dual-Axis / ORISE:
    full-duplex interaction -> reward signal

ASPIRin:
    timing reward -> projected action policy

Multi-Faceted:
    interaction reward -> four canonical axes

DuplexPO:
    long dialogue -> event-centered windows
    reward -> factorized temporal credit assignment
这就是 DuplexPO 的位置。它同意 ASPIRin 的判断:when to speak 和 what to say 需要拆开;但它没有把 action space 压成 binary state。它也同意 Multi-Faceted 的判断:pause、turn-taking、backchannel、interruption 应该分开给 reward;但它进一步把 policy update 限制到 turn transition、backchannel、barge-in 附近的 window。
所以 DuplexPO 接下来要解决的问题很具体:在保留原 action space 和 SFT 语义能力的前提下,怎样只更新那些真正决定 conversational dynamics 的局部时间窗口。
5. DuplexPO:把 conversational dynamics 单独拿出来优化
DuplexPO(arXiv:2607.07148)的核心判断是:SFT 保留 assistant 的语义能力,RL 只负责修 conversational dynamics。
论文把实时 policy 写成 frame-level formulation。用户音频流记作 x1:T,agent 的互动决策记作 y1:T。每个 frame 上,policy 预测:
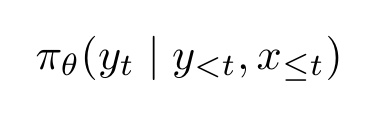
DuplexPO 的 frame-level policy:在 causal user context 和历史 agent decision 条件下预测当前 frame 的互动状态。
论文 Table 5 给出的 frame duration Δ 是 0.08s,也就是 80ms 做一次决策。这个粒度对 full-duplex 很重要,因为很多 turn-taking 和 barge-in 错误就在几帧内发生。
5.1 dynamics-critical windows
DuplexPO 没有在整段 dialogue 上 rollout。它先从长对话里抽取 dynamics-critical windows,比如 turn transition、backchannel、barge-in 附近的小窗口。窗口之前的历史用 teacher forcing,policy 只在窗口内部采样 continuation,然后计算 reward。
伪代码可以写成这样:
for dialogue in dataset:
    events = detect_turn_transition_backchannel_barge_in(dialogue)
    for window in sample_windows(events):
        prefix = dialogue[:window.start]          # teacher-forced history
        rollouts = policy.sample(prefix, window)  # only sample inside window
        rewards = FCDR(window, rollouts)
        update(policy, rollouts, rewards, reference=SFT)
这个采样单位很小,但上下文没有丢。它的好处是 credit assignment 更干净:reward 评估的就是这个窗口里的开口、短反馈、让出和正则化行为。整段对话 reward 很容易把边界错误冲淡,window-level reward 则能把错误固定在事件附近。
5.2 FCDR 在奖励什么
DuplexPO 的 reward 叫 Factorized Conversational Dynamics Reward,简称 FCDR。它把一个窗口里的互动质量拆成四项:
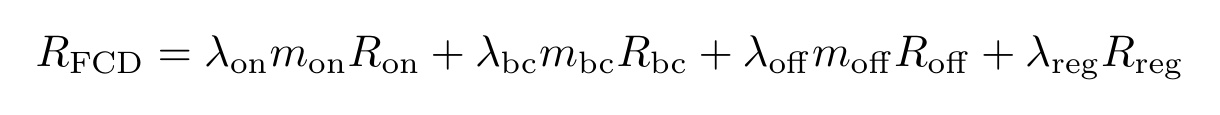
FCDR:turn initiation、backchanneling、barge-in yielding 和 pattern regularization 分别给信号,再按 event mask 激活。
论文 Table 1 里定义了四个 component:
R_on:奖励 turn initiation 的时机。预测 onset 和参考 onset 越接近,reward 越高;R_bc:奖励 backchannel 的时机。模型需要在人工标注的 backchannel interval 内或附近发出短反馈;R_off:惩罚 user barge-in 后仍然继续说。agent 在用户拿回 floor 后说得越久,惩罚越大;R_reg:惩罚不合适的 pattern,比如不该出现的持续发声。
这里的重点是 factorization。turn initiation、backchannel、yielding 对应不同失败模式。把它们拆开以后,训练时可以分别给信号,debug 时也能看出到底是哪类行为变坏。
5.3 为什么用 GRPO-style objective
每个 dynamics-critical window 内,DuplexPO sample 多个 continuation。论文 Table 5 给出的 group size 是 4。对同一窗口的多个 rollout,先按 reward 做 group normalization,得到 advantage:
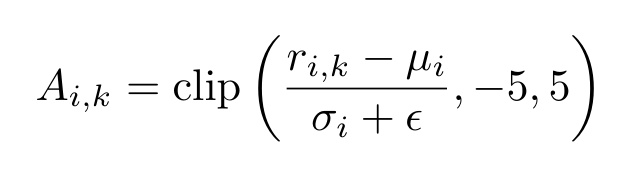
DuplexPO 使用 group-normalized advantage,保留同一窗口内多个 continuation 的相对好坏。
训练流程可以写成:
for window in sampled_windows:
    rollouts = policy.sample(window, group_size=4)
    rewards = FCDR(window, rollouts)
    advantages = normalize_within_group(rewards)

    loss = policy_gradient(
        tokens=rollouts.window_tokens,
        advantages=advantages,
        kl_reference=sft_policy,
        beta=0.2,
    )
只更新 window 内 sampled tokens,并加 KL penalty 约束到 reference SFT model。论文 Table 5 给出的 KL coefficient β 是 0.2,RL learning rate 是 1e-5,advantage clipping 是 [-5, 5]。
这个选择和 ASPIRin 的方向不同。ASPIRin 收窄 action space,避免 timing reward 影响 raw token generation;DuplexPO 保留原 action space,但把采样和更新限制在 dynamics-critical windows,并用 KL 控制 drift。两者处理的是同一个风险:interaction reward 只关心时机,但模型的动作会牵动语言生成。
论文附录 J 的 ablation 支持 GRPO-style objective。固定 FCDR 和 window sampler 后,GRPO 在多数 window-level dynamics metrics 上优于 DPO-style objective。比如 Fisher 上 backchannel yield 从 DPO 的 71.4% 到 GRPO 的 100.0%,Seamless 上 turn-taking yield 从 77.8% 到 93.6%,FDB-v3 上 yield 从 93.3% 到 100.0%。直观解释是:DPO-style objective 只用最高和最低 reward continuation,丢掉了同一窗口内更多相对排序信息。
5.4 数据和训练怎么搭起来
DuplexPO 的 training pipeline 分成四段:pre-training、SFT、DuplexPO RL、speech-synthesis SFT。实现基于 Nemotron-VoiceChat recipe 和 NeMo Toolkit,backbone 是 Qwen2.5-7B-Instruct;streaming speech encoder 是 600M 参数的 Parakeet-based encoder;speech encoder 和 codec 在训练中 frozen。论文报告所有 runs 使用 64 张 A800 80GB GPU。
数据来源也分工明确:
- speech-continuation pre-training:从大文本语料生成 530K 小时 speech-continuation examples;
- instruction-following QA:70K 小时 spoken QA data,其中 10K 小时是 single-turn;
- synthetic user interruption:agent utterance 超过 4s 时,以 0.1 概率插入 user interruption,并在 interruption 开始后给 agent 8-token reaction delay,约 0.64s;
- ASR-QA:用真实录音条件增加 speaker variation、channel effect 和 background noise;
- dynamics-aware dialogue reconstruction:从 Fisher 和 Seamless-Naturalistic-HQ 的 word-level timing 恢复对话片段,训练集包含 24.6K Fisher samples 和 43.1K Seamless samples。
这套数据设计的意图很清楚:通用语义能力靠大规模 SFT 和 QA 数据保住,interaction timing 靠自然对话 timing signal 和 window-level RL 调整。DuplexPO 避免让自然对话数据同时承担「会答题」和「会接话」两个任务,把它们拆到了不同训练阶段。
6. 实验结果说明了什么
DuplexPO 的实验需要分两组看:dynamics 有没有变好,intelligence 有没有掉。
先看 dynamics。Fisher 和 Seamless 上,DuplexPO 在 window-level turn-taking 和 backchannel 指标上明显优于 SFT Baseline(Table 2)。
| 数据集 | 模型 | Onset MAE (s) ↓ | Turn-taking yield (%) ↑ | Backchannel yield (%) ↑ |
|---|---|---|---|---|
| Fisher | SFT Baseline | 0.98 | 92.1 | 57.1 |
| Fisher | DuplexPO | 0.69 | 98.7 | 100.0 |
| Seamless | SFT Baseline | 1.22 | 78.5 | 79.4 |
| Seamless | DuplexPO | 1.03 | 93.6 | 93.3 |
FDB-v3 上更能看到 floor-control 的效果(Table 3)。
| 模型 | Latency (s) ↓ | VIR (%) ↓ | Yield (%) ↑ |
|---|---|---|---|
| SFT Baseline | 7.33 | 8.0 | 64.8 |
| DuplexPO | 0.24 | 5.0 | 100.0 |
这组结果值得注意。只让模型少说,可能降低 interruption,但 latency 会变差;只让模型早说,可能降低 latency,但容易抢话。DuplexPO 同时降低 latency 并提高 yield,说明它学到的更接近局部 floor-control policy。
conversation-level judge 也支持这个方向。Gemini pairwise judge 偏好 DuplexPO 的比例如下(Table 8,win rate 已排除 tie):
| 数据集 | Overall | Backchannel 维度 |
|---|---|---|
| Fisher | 76.9% | 91.7% |
| Seamless | 69.3% | 82.9% |
再看 intelligence。DuplexPO 没有损伤 SFT Baseline 的 QA、instruction following、speech understanding、reasoning,反而在多数指标上有小幅提升(Table 4;QA / OpenBookQA / MMSU 为准确率 %,AlpacaEval / CommonEval 为 1–5 分 GPT-score)。
| 指标 | SFT Baseline | DuplexPO |
|---|---|---|
| Llama Questions | 72.0 | 75.3 |
| WebQuestions | 44.3 | 44.5 |
| TriviaQA | 48.1 | 49.9 |
| SDQA | 47.2 | 49.8 |
| OpenBookQA | 72.2 | 73.7 |
| MMSU | 54.9 | 56.2 |
| AlpacaEval (1–5) | 3.43 | 3.68 |
| CommonEval (1–5) | 3.48 | 3.74 |
论文最核心的论据就在这里:conversational dynamics 和 model intelligence 的冲突可以被缓解。关键在训练目标怎样拆分,以及 RL 更新被限制在什么区域。
7. 对 RL infra 的启发
从 RL infra 视角看,full-duplex model RL 有几个值得单独记下来的点。
第一,sample unit 变短,但 prefix context 不能省。DuplexPO 只在 window 内 rollout,window 前的 history 仍然 teacher-forced。这样能省 rollout 长度,也保留 boundary decision 需要的上下文。
第二,reward engineering 回到行为分解。FCDR 放弃用一个大 reward model 评价整段对话,把 start、backchannel、stop、regularization 分开。这个设计对 debug 友好,也能解释具体指标为什么变化。
第三,reference policy 很关键。full-duplex timing reward 本身不约束语义质量。ASPIRin 用 action projection,Multi-Faceted Alignment 加 LLM-based response-quality reward,DuplexPO 用 window restriction 和 KL penalty。实现不同,目标一致:防止 interaction reward 把 language model 带偏。
第四,trajectory 的结构更复杂。text RL 主要处理 token sequence;full-duplex RL 还要处理 streaming frame、audio/text alignment、用户输入和 agent 输出的 overlap、实时状态切换。后续如果这类训练规模变大,infra 的难点会从「更长 sequence」扩展到「更细粒度、更强时序约束的 trajectory」。
可以把一个 full-duplex rollout 想成下面这种对象:
trajectory = {
    "user_audio_frames": x[0:T],
    "agent_audio_frames": y[0:T],
    "agent_state": ["silence", "backchannel", "speak", "yield", ...],
    "event_windows": [
        {"type": "turn_transition", "start": s1, "end": e1},
        {"type": "barge_in", "start": s2, "end": e2},
    ],
    "rewards": {
        "onset": R_on,
        "backchannel": R_bc,
        "offset": R_off,
        "regularization": R_reg,
    },
}
这比普通 prompt-response RL 多了一层时间结构。训练系统如果只把它看成一串 token,很难把 reward、mask、rollout boundary 和日志分析做好。
8. 结语
回头看这条线,full-duplex spoken model RL 的演进大概是这样:
Moshi:
    让 speech-to-speech 模型具备实时双流形态

Full-Duplex-Bench:
    把 pause / turn-taking / backchannel / interruption 拆成可测行为

User interaction alignment + ORISE:
    把真实互动和在线评估变成 RL 信号

ASPIRin:
    用 action projection 限制 timing RL 对语义生成的影响

Multi-Faceted Interactivity Alignment:
    用多轴 reward 覆盖 full-duplex 的主要互动行为

DuplexPO:
    在 dynamics-critical windows 里做局部 RL,用 FCDR 和 GRPO-style update 单独优化 conversational dynamics
DuplexPO 的价值不只在指标提升。它把 full-duplex 里的一个核心拆分讲清楚了:SFT 负责保住 what to say,RL 负责调整 when to speak。这也是 full-duplex RL 和普通 speech LLM 训练的分界点。模型以后要学的,已经不只是把语音回答生成得更好,还包括在持续变化的 shared speech stream 里学会什么时候开口、什么时候停、什么时候只用很短的声音告诉用户「我还在听」。
References
- Moshi: a speech-text foundation model for real-time dialogue, arXiv:2410.00037
- Freeze-Omni: A Smart and Low Latency Speech-to-speech Dialogue Model with Frozen LLM, arXiv:2411.00774
- Full-Duplex-Bench: A Benchmark to Evaluate Full-Duplex Spoken Dialogue Models on Turn-taking Capabilities, arXiv:2503.04721
- Efficient and Direct Duplex Modeling for Speech-to-Speech Language Model, arXiv:2505.15670
- SALMONN-omni: A Standalone Speech LLM without Codec Injection for Full-duplex Conversation, arXiv:2505.17060
- Aligning Spoken Dialogue Models from User Interactions, arXiv:2506.21463
- Reinforcement Learning Enhanced Full-Duplex Spoken Dialogue Language Models for Conversational Interactions, OpenReview
- ASPIRin: Action Space Projection for Interactivity-Optimized Reinforcement Learning in Full-Duplex Speech Language Models, arXiv:2604.10065
- Dual-Axis Generative Reward Model Toward Semantic and Turn-taking Robustness in Interactive Spoken Dialogue Models, arXiv:2604.14920
- Multi-Faceted Interactivity Alignment in Full-Duplex Speech Models, arXiv:2606.11167
- Decoupling Conversational Dynamics in Full-Duplex Spoken Models through Reinforcement Learning, arXiv:2607.07148